一个智能体配上一套工具,已经能完成相当多任务。但让它同时“当产品经理、写后端、跑测试、做代码评审”,很快就会露馅:上下文里塞满了互相干扰的指令,十几件工具的清单来回切换,任务做到一半忘了开头。解法看起来很自然——像人类团队一样分工:让多个智能体各司其职,由一个协调者调度,这就是 Multi-Agent(多智能体)系统。它也是 2026 年智能体工程里讨论度最高、误用率也最高的架构。本文按“架构模式 → 通信机制 → 框架选型 → 工程挑战 → 适用边界 → 总结”组织全文。
1、概述
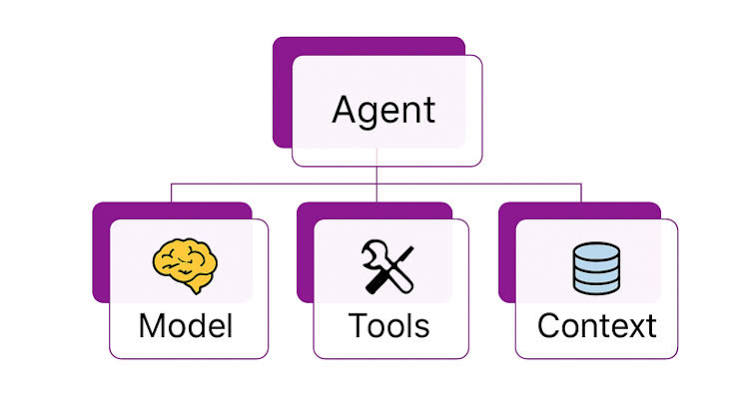
先厘清概念。单个智能体 = 模型 + 工具 + 循环:接收任务,推理,调工具,观察,循环直到完成。Multi-Agent 系统则是多个这样的智能体协作完成一个任务,彼此之间有分工、有通信、有调度。
为什么需要多个?根本原因不是“模型不够聪明”,而是上下文是一种稀缺资源。单个智能体长任务跑下来,历史越积越长:无关信息稀释注意力,长上下文中段利用率衰减,多任务指令互相打架。而一个只干一件事的智能体,上下文干净、指令聚焦、工具清单短——每个“专家”都比一个“全才”更可靠。此外还有并行收益:无依赖的子任务可以同时推进,以及隔离收益:一个子任务的失败不会污染主任务的上下文。
但多智能体的代价同样真实:通信开销翻倍、调试难度指数级上升、成本成倍增长。Anthropic 在工程实践中反复强调的原则值得刻在脑门上:能单智能体解决的,不要上多智能体。多智能体是“性能优化”,不是“默认架构”。
2、核心协作架构模式
工程界沉淀出几种稳定的协作模式,按协调方式从紧到松排列。
2.1、编排者-执行者模式
一个“编排者”(Orchestrator)负责任务分解与结果汇总,若干“执行者”(Worker)各带专属工具完成子任务。这是当前生产系统采用率最高的模式,流程如下:
编排者的核心职责是“拆得对、合得拢”:把大任务拆成边界清晰的子任务,给每个子任务指定合适的执行者与验收标准。审查环节发现问题时,重新分解返工——这个回路是多智能体质量保障的关键,没有审查的编排者只是个转发器。
2.2、流水线模式
按工序串行传递:需求分析 → 方案设计 → 编码实现 → 测试评审,每个环节一个智能体,产出作为下一环节的输入。它的优势是阶段边界清晰、每步可检查;代价是串行延迟高,任何一步阻塞整条链。适合流程固化的场景,如内容生产流水线。
2.3、辩论模式
多个观点不同的智能体就同一问题给出答案并互相批驳,再由裁判智能体(或人类)裁决。它用分歧对冲幻觉,适合高风险、答案不唯一的判断类任务——方案评审、漏洞分析、事实核查。代价是 token 成本直接乘以参与方数量。
2.4、对等协作模式
没有固定指挥链,智能体之间点对点交接任务。OpenAI 早期实验框架 Swarm(现已被 OpenAI Agents SDK 取代)用“交接”(Handoff)机制实现这种模式:客服智能体判断问题属于退款,就原地把任务连同完整对话历史移交给退款专员。它像一支小团队:谁擅长谁接手,无需事事上报。
四种模式的特性对比如下:
| 模式 | 协调方式 | 适用场景 |
|---|---|---|
| 编排者-执行者 | 中心调度 | 复杂大任务分解 |
| 流水线 | 串行传递 | 固化流程 |
| 辩论 | 互相批驳 | 高风险判断 |
| 对等协作 | 互相交接 | 客服分流类 |
3、通信与协作机制
模式解决“怎么组织”,通信机制解决“怎么传递”。生产系统里有三种主流机制。
消息传递是最基础的形式:智能体 A 的输出作为消息发给智能体 B。简单直接,但要注意消息粒度——全量转发历史会让上下文爆炸,应当只传“结论 + 必要证据”。
交接(Handoff)是消息传递的特化:不是传一份信息,而是移交整个任务的执行权。接手的智能体收到完整对话历史与任务说明,用户无感知。它非常适合“分流”场景:不同专家处理不同类型的问题,入口智能体只做识别与路由。
**共享状态(黑板模式)**让多个智能体读写同一份结构化工作区——一个任务清单、一份文档草稿、一个代码仓库。执行者不直接对话,而是通过修改黑板协同。编码智能体 CLI 工具大量采用这种模式:规划者把任务写入清单文件,实现者逐项认领并勾选完成。共享状态的优势是信息不丢失、过程可审计,天然适配长时间运行的自主任务。
机制听上去抽象,落成代码却很短。一个只依赖 OpenAI SDK、不含任何框架的最小编排者骨架如下:
from openai import OpenAI

client = OpenAI()

def ask(system: str, user: str) -> str:
    resp = client.chat.completions.create(
        model="gpt-4o",
        messages=[{"role": "system", "content": system},
                  {"role": "user", "content": user}])
    return resp.choices[0].message.content

def orchestrate(task: str) -> str:
    plan = ask("你是编排者,把任务拆成 2~4 个独立子任务,每行一个。", task)
    subtasks = [t for t in plan.splitlines() if t.strip()]
    results = [ask("你是执行者,只负责完成这一个子任务:", f"子任务:{t}")
               for t in subtasks]  # 无依赖的子任务可换成线程池并发
    return ask("你是编排者,审查以下结果,不合格先指出问题再汇总:",
               "\n".join(results))
解读:三次 ask 调用分别对应编排者的三个职责——分解、汇总、审查。审查环节是质量闸门:它可以在发现不合格结果时退回重做,这正是第二节流程图里“不通过则重新分解”回路的代码形态。把串行推导换成线程池,就获得了并行执行收益;把 ask 替换成带工具的智能体,它就长成了完整的编排者-执行者系统。
多智能体系统里,通信设计的第一敌人是“信息全文转发”——带宽不受控的团队,注定撑不过一个复杂任务。
4、框架选型现状
2026 年的多智能体框架版图经历了一轮洗牌,选型前必须知道三件事:微软的 AutoGen 已归档停止维护,官方引导用户迁移到继任者 Microsoft Agent Framework;OpenAI 的实验框架 Swarm 已由生产级的 OpenAI Agents SDK 取代;LangGraph 明确转型为底层运行时,官方推荐在其上使用 Deep Agents 等高层封装。三个关键仓库:AutoGen(已归档)、OpenAI Agents SDK、LangGraph。
主流选项的定位对比如下:
| 框架 | 定位 | 适合人群 |
|---|---|---|
| OpenAI Agents SDK | 轻量,交接与护栏内建 | 快速上手多智能体 |
| LangGraph | 底层有状态运行时 | 需要深度定制与持久化 |
| CrewAI | 角色扮演式编排 | 业务流程编排场景 |
| Microsoft Agent Framework | AutoGen 继任者 | 微软生态与企业场景 |
CrewAI 以“角色扮演”心智模型见长:每个智能体定义角色、目标与背景故事,协作方式接近人类团队的分工直觉,对非算法背景的开发者上手友好。OpenAI Agents SDK 则胜在极简:Agent + 交接 + 护栏三个原语就构成全部抽象,并支持接入上百种第三方模型。LangGraph 提供的是最底层的能力:图结构编排、检查点持久化、人工介入中断恢复——代价是一切要自己搭。
选型的务实建议:先用 OpenAI Agents SDK 理解多智能体的最小形态;要长期运行、可恢复的重计算任务,上 LangGraph;要用业务角色分工的方式描述系统,考虑 CrewAI。无论选哪个,把“编排逻辑”写在普通代码里(而非提示词里)的系统,可维护性总是更好。
以 OpenAI Agents SDK 为例,运行一个智能体只需三行代码,它的上手成本可见一斑:
from agents import Agent, Runner

agent = Agent(name="Assistant", instructions="You are a helpful assistant")
result = Runner.run_sync(agent, "Write a haiku about recursion.")
print(result.final_output)
解读:Agent 由指令、工具、交接、护栏配置而成,Runner 承载运行循环。单个智能体如此简洁,再加上 handoffs 参数声明可交接的目标智能体,就是一套可运行的对等协作系统——框架的价值在于把循环与状态管理从你的业务代码里拿走,而不是替你思考架构。
5、工程挑战
多智能体系统的工程难度,呈数量级高于单智能体,主要来自四个方面。
成本失控是第一位的。一次多智能体任务的总 token 消耗,常常是单智能体的十倍以上:分解要调用,每个子任务要调用,汇总审查还要调用。优化手段:控制执行者数量、压缩传递的消息、给子智能体配小参数模型——编排者用强模型、执行者按需降级,是性价比最高的分级策略。
调试黑盒化。任务失败时,是分解错了、执行错了,还是汇总错了?没有链路追踪就是抓瞎。必须有全链路的执行记录:每个智能体的每次调用、每条消息、每个决策点。各框架配套的观测方案(如 LangGraph 配套 LangSmith)不是可选项,是必需品。
确定性流失。同一输入两次运行,分解方式、执行顺序、中间结论都可能不同。对抗手段:温度调低、关键编排逻辑用代码硬编码、审查环节设置明确可判定的验收标准,而不是“觉得没问题就通过”。
测试复杂度。单智能体测的是“一个回答”,多智能体要测的是“一条协作轨迹”。可行的做法:先对每个智能体单独做单元测试(固定输入断言工具调用序列),再对典型任务做端到端回归用例。没有分层的测试,多智能体系统的每次改动都是赌博。
6、什么时候需要多智能体
回到那个最值钱的问题:什么时候才应该上多智能体?判断依据可以收敛为四条,满足越多,越值得拆:
- 任务确实庞大:单次上下文装不下全部过程信息
- 角色天然冲突:生成与评审分离,才可能“自己检查出自己”的错误
- 子任务可并行:拆开能真正缩短墙钟时间
- 工具清单过长:单智能体背着几十个工具,误调率显著上升
反过来,四种情况建议留在单智能体:任务能在一屏上下文里说清;延迟敏感(多智能体的多次通信会显著放大响应时间);预算有限;还没有可观测的基础设施。Anthropic 的实践总结里说得很直白:大多数场景下,一条精心设计的单智能体流水线,优于一套仓促拼凑的多智能体系统,详见 Building Effective Agents。
一个务实的演进路径:从单智能体开始,让真实失败推动拆分——当它开始忘事、开始选错工具、开始在长任务里失控,那时再按“编排者-执行者”把稳定成型的部分拆出去。拆分是被证据逼出来的,而不是被论文预告出来的。
7、总结
回顾全文:多智能体系统用“分工”对抗上下文稀缺,用“隔离”换取单任务可靠性;编排者-执行者是生产首选,流水线、辩论与对等交接各有其位;通信上,交接机制与共享状态比全文转发更健壮;选型上,AutoGen 已归档、Swarm 已升级为 Agents SDK,LangGraph 沉淀为底层运行时;工程上,成本、追踪、确定性与分层测试是四道必须迈过的坎;而最重要的判断——多智能体是“被失败逼出来的优化”,不是起点。
对于准备动手的团队,建议把“能单智能体解决,就先不拆”的原则贴在墙上。先把单智能体的提示词、工具、评测打磨到位,再让真实的失败案例告诉你该拆什么——按证据拆出来的系统,才养得起它的成本与复杂度。