全站置顶分享
AI不会取代优秀的工程师,但优秀的工程师一定会驾驭AI
"AI 不会取代优秀的工程师,但优秀的工程师一定会驾驭 AI。"这句话在过去两年被反复引用,从技术大会讲到招聘启事。引用的人多了,它就开始像一句口号——很少有人追问:驾驭到底指什么?为什么不是所有人都能驾驭? 口号不值得写一篇文章,但数据值得。Stack Overflow 2025 开发者调查、METR 的两轮随机对照实验、Google Cloud 的 DORA(DevOps Research a…
12
"AI 不会取代优秀的工程师,但优秀的工程师一定会驾驭 AI。"这句话在过去两年被反复引用,从技术大会讲到招聘启事。引用的人多了,它就开始像一句口号——很少有人追问:驾驭到底指什么?为什么不是所有人都能驾驭? 口号不值得写一篇文章,但数据值得。Stack Overflow 2025 开发者调查、METR 的两轮随机对照实验、Google Cloud 的 DORA(DevOps Research a…

博客从 2019 年国庆用 Xiuno BBS 搭建,到 2026 年国庆整整七年。868 篇文章、53 条评论、6060 个代码块,这次与 AI Agent 结对,一天完成从 PHP 论坛到 Next.js 的整体重构与无损迁移。
国内 AI 编程工具的竞争已经从「补全谁更准」升级到「智能体工作台谁更完整」。阿里系的 Qoderhttps://qoder.cn/ 是这条新赛道上的重量级选手:以编程智能体为核心引擎的智能体工作台,官方宣称开发者规模已…
AI 办公赛道在 2026 年迎来了标志性选手:腾讯 CodeBuddy 团队在 3 月推出的 WorkBuddyhttps://www.workbuddy.cn/,定位「全场景 AI 办公工作台」——你说出要求,它自主…
从豆包 MarsCode 到 Trae,再到 TraeCode 与 TraeWork 双线并进、最终融合为统一的 TRAEhttps://www.trae.cn/,字节的 AI 编程产品在两年里走完了一条快速演化的路线。…
写邮件带代码片段是件苦差事:用富文本编辑器缩进、换字体、调颜色,十分钟过去格式还是乱的。有个荒诞的工作流曾流行一时——在 GitHub 网页编辑器里写 Markdown,预览完再把渲染结果复制回邮箱。adam-p 为此写了一个浏览器扩展:Markdown Here,在邮箱编辑框里写 Markdown,右键一点,直接渲染成排版精美的 HTML 邮件。 它支持 Chrome、Firefox、Opera…
每个用 Markdown 写过东西的人,大概都经历过同一套困惑:为什么这家平台的表格语法和那家不一样?GitHub 上的删除线和任务列表,搬到别的编辑器就失效了?查语法时搜出来的教程质量参差,版本各异,越查越乱。这些问题的根源都是一个——Markdown 方言(flavors)林立,而多数教程只讲其中一种。 Markdown Guide 是这个领域的权威解法:一份同时面向新手与专家的完整参考,按基…
学算法的路上,最容易卡住的不是理解思想,而是找不到一份「能跑、能改、注释清楚」的参考实现。教科书伪代码离运行差一步,竞赛代码又压缩得面目全非。TheAlgorithms/Python 恰好补上这个空档:两万多个算法文件,…
很多跑了多年的系统,搜索功能背后就是一条 LIKE '%关键词%':演示的时候够用,数据量和用户耐心上来之后,它开始慢、开始漏、开始返回一堆不相关的结果。把这样的存量搜索升级成语义搜索,不需要推倒重来,也不必一步换成向量…
企业知识库动辄几十万份文档,再大的上下文窗口也装不下,更装不下"明天新增的知识"。给模型注入知识有两条主路:RAG 是外挂,先把相关内容检索出来再喂进上下文;微调是内炼,用数据把能力炼进模型权重。两条路线的成本结构、能力边界差异极大,选错的代价往往是几个月的弯路。 这两条路的主次关系也在变:2020 年前后模型弱、窗口小,微调几乎是唯一选项;2023 年之后模型变强、窗口变大、嵌入变好,RAG 逐…
想要一个自己的 AI 助手,面前通常摆着两条路:用托管服务,省心但对话、文件、偏好都存在别人家里;用开源框架自建,数据是自己的了,可重量级框架的抽象层层叠叠,想改一处行为得先读懂半个系统。港大数据智能实验室 HKUDS 的 nanobot 给出了第三条路:一个超轻量、开箱即用的自托管个人 AI agent——核心小到读得懂,能力又齐到真能当日常助手用。 本文按"是什么、什么哲学、能干什么、怎么上手…
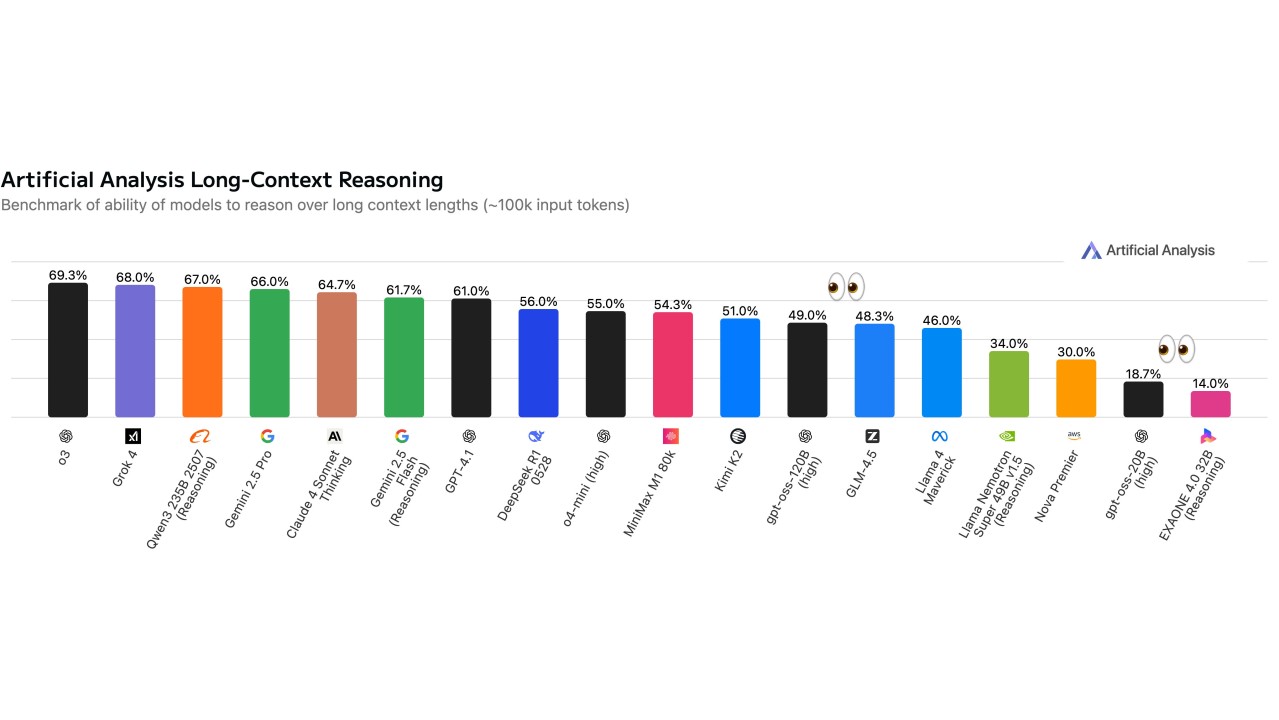
选大模型时,厂商的发布博客和各家榜单经常互相矛盾——A 家说智能第一,B 家说性价比最优,第三方跑分又和方法论打架。久而久之,行业需要一个口径统一、立场独立的参照系。Artificial Analysis(AA)做的就是这件事:独立测评 AI 模型与提供商,用自建的 Intelligence Index、速度、成本三维数据帮用户按场景选模型选厂商。它不隶属于任何模型厂商,评测自己跑、榜单自己发,已…
社区子代理集合里的评审类 Agent 通常有个通病:清单又长又散,看起来覆盖一切,实际上没有优先级、没有输出契约,模型跑完不知道该报什么。awesome-claude-code-subagents 里的 code-reviewer 是这类设计的集大成者:十一个评审维度的清单矩阵加三阶段工作流,一个 Agent 覆盖代码质量、安全、性能、设计模式、测试、文档、依赖、技术债、语言特化与评审自动化——瑞…
类型系统的一个经典论断:让非法状态不可表示(make illegal states unrepresentable)——设计得好的类型在编译期就堵死 bug,而不是靠运行时检查和文档约定兜底。pr-review-toolkit 插件里的 type-design-analyzer Agent 把这套类型设计方法论做成了自动化审计:识别类型的不变量(invariants),从封装性、表达力、实用性、执…
AI 写代码有个通病:第一版能跑,但往往绕——嵌套三元、冗余抽象、过度紧凑的一行流。人类工程师会回头"收拾"代码,AI 通常不会。claude-plugins-official 里的 code-simplifier Agent 把"收拾"这件事自动化了:在严格保持功能不变的前提下简化与精炼近期修改过的代码——降嵌套、去冗余、提清晰度,同时警惕"过度简化"。本文按"定位 → 简化原则 → 项目标准 …
线上最凶险的 bug 不是报错,而是不报错——空 catch 块吞掉异常、兜底逻辑悄悄降级、可选链静默跳过失败操作,用户只觉得"功能怪怪的",开发者查日志一片干净。pr-review-toolkit 插件里的 silent-failure-hunter Agent 专猎这类静默失败:以"零容忍"立场审计错误处理代码,从日志质量、用户反馈、catch 特异性、兜底正当性、错误传播五个维度逐一拷问。本…
"这个 PR 的测试够不够?"是最难回答的评审问题之一——行覆盖率 90% 可能全是测了 getter,关键错误分支一条没碰。pr-review-toolkit 插件里的 pr-test-analyzer Agent 把这个问题工程化了:专审 PR 的测试覆盖质量,聚焦行为覆盖而非行覆盖,对每个缺口给出 1~10 关键度评分——同时明确反对"100% 覆盖的学究式追求"。本文按"定位 → 覆盖分析…
注释会撒谎——代码改了三版,注释还停留在第一版,后来者照着注释理解代码,一头栽进坑里。这个问题有个专门的名字:comment rot(注释腐烂)。pr-review-toolkit 插件里的 comment-analyzer Agent 就是冲它来的:以"健康的怀疑主义"逐条核对注释与代码的事实一致性,评估完整性与长期价值,专防文档性技术债。本文按"定位 → 分析框架 → 输出契约 → 提示词工艺…
Python 的 lint 环节长期是个性能黑洞:Flake8 加一堆插件跑全仓要几十秒,Black 格式化大项目也要等上一会儿。Ruffhttps://github.com/astralsh/ruff 用 Rust 把…
Apple Silicon 统一内存的Mac 越买越多,家里一台 MacBook、一台 Mac mini、一台 Mac Studio,每一台单独都塞不下 671B 参数的大模型,于是大部分算力在吃灰。买 8 张 H100 组集群对个人是玩笑,但把现有设备拼成一台"大内存机器"不是——缺的只是一层像样的分布式推理软件。 exo 就是干这件事的:它把同一网络里的所有设备组成一个 AI 集群,自动发现、…