文字编码
文字编码不同往往会造成乱码等问题,如果不知道问题在哪,就会急得像热锅上的蚂蚁(法语乱码问题)。所以写代码还是要对各种不同的编码有所了解。
1、ASCII码
American Standard Code for Information 美国信息交换标准代码。ASCII码是单字节编码,使用7位二进制数表示。编码范围是0x00-0x7F(最高位保持为0,0 - 127),可表达128个字符。
ASCII字符集包括英文字母、阿拉伯数字和标点符号等字符。ASCII码字符不存在乱码问题,因为绝大部分地区编码都兼容ascii。其中0x00-0x20和0x7F共33个控制字符,只支持ASCII码的系统会忽略每个字节的最高位,只认为低7位是有效位。
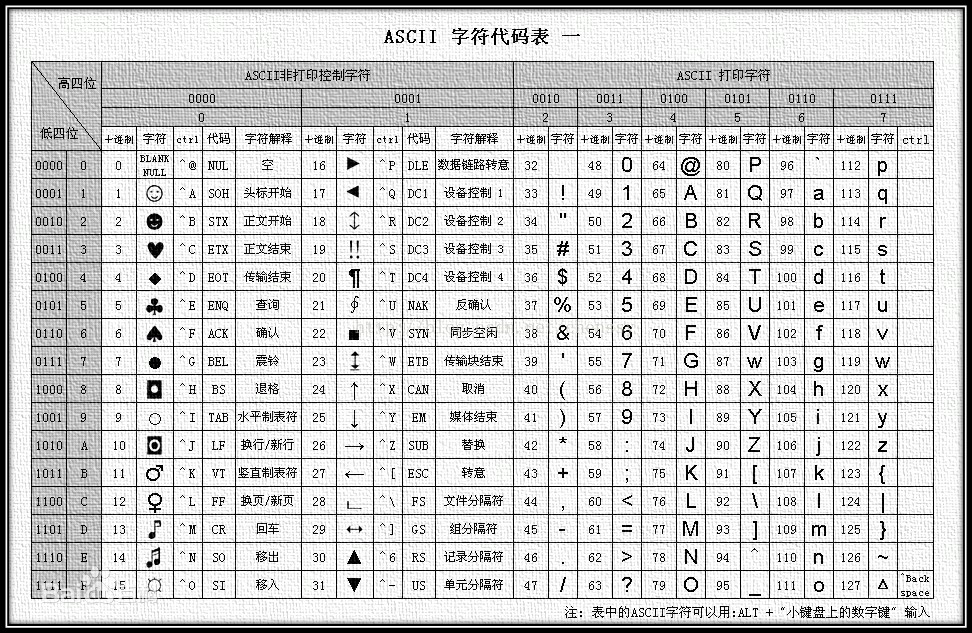
标准ASCII码只用到一个字节中的7位,如果使用第8位,则可扩展编码范围128 - 255,扩展后的标准即为ISO8859-1,也称为 Latin-1
2、Unicode
Unicode是全世界统一的编码规则,但是这个只规定了各种字符的数字编码(相当于一种标准),Unicode的实现方式称为Unicode转换格式(Unicode Transformation Format,简称为UTF),如UTF-8、UTF-16等。
各种形式有不同的存储和与unicode代码的映射规则。目前的 Unicode 字符分为 17 组编排, 每组称为平面(Plane),而每平面拥有65536个代码点。
3、ISO 10646
ISO 10646标准由国际标准化组织ISO颁布,用来实现全球所有文种的统一编码;ISO 10646定义了标准字符集(Universal Character Set,UCS);
历史上存在两个独立的尝试创立单一字符集的组织,即国际标准化组织(ISO)和多语言软件制造商组成的统一码联盟即Unicode。前者开发了ISO/IEC 10646 项目,后者开发了统一码项目。因此最初制定了不同的标准。1991年前后,两个项目的参与者都认识到,世界不需要两个不兼容的字符集。于是,它们开始合并双方的工作成果,并为创立一个单一编码表而协同工作。
4、ISO8859
ISO 8859,全称ISO/IEC 8859,是一个8位字符集的标准,现时定义了15个字符集。 兼容ASCII,0x20 - 0x7F为ASCII,0xA0-0xFF为ISO 8859-x字符,Unicode 0x00-0xFF范围的字符由 0x00-0x7F(ASCII) + 0x80-0x9F(控制符) + 0xA0-0xFF(ISO 8859-1)组成
各种ISO 8859字符集如下 :
ISO/IEC 8859-1 (Latin-1) - 西欧语言
ISO/IEC 8859-2 (Latin-2) - 中欧语言
ISO/IEC 8859-3 (Latin-3) - 南欧语言。世界语也可用此字符集显示。
ISO/IEC 8859-4 (Latin-4) - 北欧语言
ISO/IEC 8859-5 (Cyrillic) - 斯拉夫语言
ISO/IEC 8859-6 (Arabic) - 阿拉伯语
ISO/IEC 8859-7 (Greek) - 希腊语
ISO/IEC 8859-8 (Hebrew) - 希伯来语(视觉顺序)
ISO 8859-8-I - 希伯来语(逻辑顺序)
ISO/IEC 8859-9(Latin-5 或 Turkish)- 它把Latin-1的冰岛语字母换走,加入土耳其语字母。
ISO/IEC 8859-10(Latin-6 或 Nordic)- 北日耳曼语支,用来代替Latin-4。
ISO/IEC 8859-11 (Thai) - 泰语,从泰国的 TIS620 标准字集演化而来。
ISO/IEC 8859-13(Latin-7 或 Baltic Rim)- 波罗的语族
ISO/IEC 8859-14(Latin-8 或 Celtic)- 凯尔特语族
ISO/IEC 8859-15 (Latin-9) - 西欧语言,加入Latin-1欠缺的芬兰语字母和大写法语重音字母,以及欧元(€)符号。
ISO/IEC 8859-16 (Latin-10) - 东南欧语言。主要供罗马尼亚语使用,并加入欧元符号。
由于英语没有任何重音字母(不计外来词),故可使用以上十五个字集中的任何一个来表示。
5、GB2312
GB2312 是对 ASCII 的中文扩展,正式的名称为MBCS(Multi-Byte Chactacter System,多字节字符系统)按照程序员的称呼,GB2312、GBK到GB18030都属于双字节字符集 (DBCS)。
规定:一个小于127的字符的意义与原来相同,但两个大于127的字符连在一起时,就表示一个汉字,前面的一个字节(他称之为高字节)从0xA1用到 0xF7,后面一个字节(低字节)从0xA1到0xFE,这样我们就可以组合出大约7000多个简体汉字了
6、GBK
GBK最初是由微软对GB2312的扩展。总体编码范围为 8140-FEFE,首字节在 81-FE 之间,尾字节在 40-FE 之间。
不再要求低字节一定是127号之后的内码,只要第一个字节是大于127就固定表示这是一个汉字的开始,不管后面跟的是不是扩展字符集里的内容。
7、BIG5
BIG5 字符集,繁体中文编码。1984年由台湾财团法人信息工业策进会和五间软件公司宏碁 (Acer)、神通 (MiTAC)、佳佳、零壹 (Zero One)、大众 (FIC)创立,故称大五码.
Big5码使用了双字节储存方法,以两个字节来编码一个字。第一个字节称为“高位字节”,第二个字节称为“低位字节”。高位字节的编码范围0xA1-0xF9,低位字节的编码范围0x40-0x7E及0xA1-0xFE。
各编码范围对应的字符类型如下:
0xA140-0xA3BF为标点符号、希腊字母及特殊符号,
0xA259-0xA261,存放了双音节度量衡单位用字:兙兛兞兝兡兣嗧瓩糎;
0xA440-0xC67E为常用汉字,先按笔划再按部首排序;
0xC940-0xF9D5为次常用汉字,亦是先按笔划再按部首排序。