循环、工具、上下文管理,这些机制层的话题解决的是"有没有"的问题;再往上是一层设计学问:循环该怎么组织、任务该怎么拆、多个模型该怎么协作,这就是 agent 设计模式。模式本质上是一套约定:往循环里放什么、什么时候停、结果怎么汇合。与之配套的另一半是 MCP——把工具接入从各家私有协议收敛成一个开放标准,同一个数据源一次封装、处处可用。
本文从最核心的 ReAct 循环讲起,过一遍规划、反思、记忆与多 agent 协作,最后拆 MCP 的协议形态。demo 与产品的差距,多半就体现在这些设计上。
1、从机制到设计
同一套"循环加工具"的机制,组织方式不同,效果天差地别。几个经过大量实践检验的模式概览如下:
| 模式 | 一句话 | 适合 |
|---|---|---|
| ReAct | 边想边做,循环推进 | 通用任务 |
| 规划 | 先列计划再逐步执行 | 长任务多步骤 |
| 反思 | 产出后自检一遍 | 质量敏感任务 |
| 多 agent | 主控分派,并行干活 | 可拆分的探索型任务 |
Anthropic 的实践总结 Building Effective Agents 对这些模式有完整展开,核心主张与工程直觉一致:从最简单的模式起步,复杂度只在任务证明需要时增加。
2、ReAct 核心循环
ReAct 是 reasoning 与 acting 的合写,出自 ReAct 论文:模型先输出一段思考,再发起一个动作,观察结果后再思考下一步——思考、行动、观察,三段循环。它是一切 agent 循环的原型,今天各类产品里的"显示思考"就源于此。最小骨架如下:
messages = [task_message]
while True:
    resp = llm(messages, tools=TOOLS)        # 思考并决定行动
    messages.append(resp)
    if resp.stop_reason != "tool_use":       # 思考完毕,给出答案
        break
    for call in resp.tool_calls:             # 行动
        messages.append(run_and_wrap(call))  # 观察结果拼回历史
用一个最小轨迹看三段如何接力:思考——"用户要查上海的天气,需要调用天气工具";行动——调用 weather(city=上海);观察——"晴,22 度";下一轮思考——"信息足够,可以作答"。三段交替,任务在循环里逐步向前。循环里模型只做两件事:决定下一步做什么,判断是否可以收尾。值得点破的是:模型并没有变成别的东西,它仍是那个文本进、文本出的概率机器,是循环结构给了它持续行动的样子——Agent 不是更聪明的模型,而是被组织起来的模型。
循环还带来一样单次问答没有的东西:错误可以被观察纠正。模型这步想错了、搜错了词,下一轮的观察会把事实摆回眼前,偏差被循环消化——这是 agent 比一次性问答鲁棒的根本原因。简单模式的全部力量在于可预测——每一步都可观测、可干预、可重放。
两个常见失败形态要提前设防:无限循环——模型反复调用同一个工具不收敛,对策是设轮次上限加重复检测;过早收尾——信息不够就抢答,对策是把完成标准写进任务描述("必须至少核验两个来源")。另一个容易忽视的杠杆是工具质量:描述写得越清楚,模型绕的路越少——每少绕一轮,省的是一整轮的输入输出 token,工具描述是性价比最高的优化点。
工具结果的回传也有规范:执行出错要把错误信息原样回传并标记失败,别吞异常硬造一个空结果——模型看到"调用失败:文件不存在"会自己换路子,看到空字符串只会困惑地重试。前几年全自主循环的实验也给了反面教材:不加约束的长循环大概率跑偏,烧完 token 一事无成;业界的收敛结论很朴素——小循环、勤检查、有明确的完成标准,复杂度留在设计里,不留在循环里。
3、规划与反思
ReAct 走一步看一步,长任务容易迷路。规划模式先让模型产出显式的步骤清单,再逐步执行并逐项勾销,适合有依赖顺序的多阶段任务;执行中发现计划不合实际,就让模型显式重列计划——重规划本身就是规划模式的一部分,不是异常。反思模式在产出之后追加一轮自检——"检查上面的结果,列出问题并修正"——等于把一个模型当两个用,作者写完、审稿人挑刺,对质量敏感的任务收益明显,写代码时自查一遍尤其有效。
反思的收益是有条件的:在可验证的领域(代码能跑、数学能算、格式能查),自检有硬标准可依,收益大;在纯主观的领域,自检容易退化成空转的套话。两个可直接抄的提示词骨架:规划用"先输出编号步骤清单,每完成一步更新状态再继续";反思用"完成后列出潜在问题与验证方式,修正后再给最终版"。模式落到提示词上,不过几句话。两者的代价都是更多轮次、更多 token、更长延迟——按"返工成本是否高于多花几轮"来判断值不值得,而不是无脑全开。
4、记忆的三层
agent 的记忆不是一件事,是三层结构,载体与生命周期各不相同:
| 层 | 载体 | 容量与生命周期 |
|---|---|---|
| 工作记忆 | 上下文窗口 | 最大也最短,会话结束即消失 |
| 情景记忆 | 会话摘要与压缩 | 跨轮次保留要点 |
| 长期记忆 | 外部文件与知识库 | 跨会话,按需读回 |
写入策略决定这套结构好不好用:任务完成时把结论落进长期记忆,窗口接近上限时把过程压缩成情景摘要,需要旧细节时按需检索读回——而不是把一切都堆在窗口里。长期记忆的主流做法朴素得惊人:用文件。把重要事实、用户偏好、任务结论写进 markdown,下次开工先读一遍——本质上就是给自己做的 RAG。还要防记忆污染:错误的结论一旦落盘会被反复引用,越用越自信;长期记忆需要淘汰机制,过期的、与近期事实矛盾的条目要能标记和清理。设计要点是分清"什么必须在窗口里、什么可以外置":窗口只留给真正在思考的东西。
5、多 agent 协作
单 agent 的窗口装不下"读五十份文档再汇总"这类任务,于是有了多 agent。这种分派结构有个通用名字:orchestrator-workers——主 agent 拆解任务、分派 worker、汇总结果;每个 worker 拿着独立的一份上下文并行干活。通信协议的关键是只交摘要:worker 回报结论与关键证据,而不是把读过的原始内容倒回来,否则主控的窗口会被灌爆,拆分就失去了意义。
给 worker 的任务书还要自包含:目标、边界、输出格式一次说清,worker 不该再回头追问主控——每多一轮往返,就多一份上下文复制。任务书写得像给外包团队的工单,协作就顺。
它的适用面很明确——可拆分、可并行、以检索阅读为主的探索型任务;两个不适合的信号也要认识:子任务强耦合时,来回同步的通信成本会吃掉并行收益;任务很短时,上下文复制的成本大于节省的时间。收益有两个:上下文隔离——每个 worker 只看自己那部分,互不污染;注意力聚焦——几个各怀专念的模型,胜过一个满脑子全任务的模型。代价同样明确:每个 worker 都要复制一份基础上下文,token 成本陡增,且误差会级联——上游拆错方向,下游全线白干。Anthropic 工程团队的多 agent 研究系统实践复盘给出了生产环境的经验数字,值得在动手前读一遍。
6、MCP 工具接入标准
工具接入曾是"每家客户端一套私有协议":同一份数据源,接 IDE 写一遍,接聊天助手再写一遍。MCP(Model Context Protocol,Anthropic 于 2024 年 11 月开源发布,此后各厂相继接入)把它收敛为开放标准:工具或数据源封装成 MCP server,统一暴露工具、资源与提示词;任何实现了协议的 host——IDE、桌面助手、agent 框架——即插即用。类比是 USB-C:出现之前每种设备一种接口,之后一线通用——M 个应用对接 N 个工具,从 M 乘 N 份胶水变成 M 加 N 份实现。官方规范与各语言 SDK 见 modelcontextprotocol.io 与 GitHub 组织。
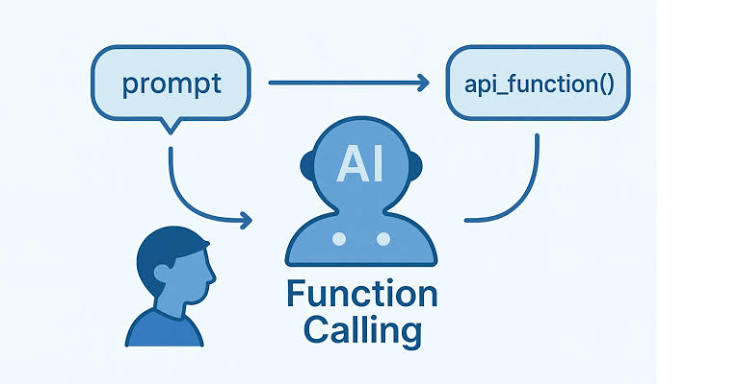
一个常见的混淆值得澄清:MCP 与各家 API 的工具定义(function calling)是两层互补的东西——API 层约定"模型怎么发起一次调用",MCP 层约定"应用从哪里接入工具的提供方"。一个管话术,一个管货源,谁也不取代谁。server 侧的工具声明形似:
{
  "name": "query_orders",
  "description": "按用户编号查询订单列表",
  "inputSchema": {
    "type": "object",
    "properties": {"user_id": {"type": "string"}},
    "required": ["user_id"]
  }
}
结构与各家 API 的工具定义几乎同构,迁移成本低;host 拿到的是标准清单,调用与结果回传也都走标准消息。一次接入、处处可用是协议的核心卖点,交互时序如下:
图中从握手到调用都是标准消息,host 不需要知道 server 背后是数据库还是第三方接口——工具生态由此从"点对点对接"变成"插座即标准"。传输上 MCP 支持本地 stdio 与远程 HTTP 两种形态:本地工具走前者,服务化数据源走后者。安全上守住两条:工具描述也是提示词的一部分,不可信来源的 server 可能在描述里夹带注入;权限按最小化授权,与自研工具同一标准。封装 server 时还有一个设计选择:只读的数据查询更适合做成资源,由 host 按需读取;会改变状态的操作才做成工具。资源与工具各安其位,权限模型也跟着清晰。
7、总结
回顾全文:ReAct 是一切循环的原型,规划治迷路,反思保质量,记忆分三层各司其职,多 agent 用上下文复制换并行能力,MCP 用标准协议终结工具的点对点对接。对于正在做 agent 产品的团队,建议从单 agent 的 ReAct 起步、把观测做扎实,任务长了再上规划,真正遇到并行瓶颈才拆多 agent;工具接入从第一天就走 MCP,别再给每个客户端写一遍胶水。