云原生全景综述:知识地图与选型
本文是系列收官篇:把前 24 篇的项目放进 CNCF 全景图坐标系,梳理技术演进脉络,给出一套"从问题出发"的选型决策框架。 | 系列回顾 | 覆盖 | | | | | 存储与数据库 | 第 14 篇(db_tutori…
27
# 标签
共 16 篇文章
本文是系列收官篇:把前 24 篇的项目放进 CNCF 全景图坐标系,梳理技术演进脉络,给出一套"从问题出发"的选型决策框架。 | 系列回顾 | 覆盖 | | | | | 存储与数据库 | 第 14 篇(db_tutori…
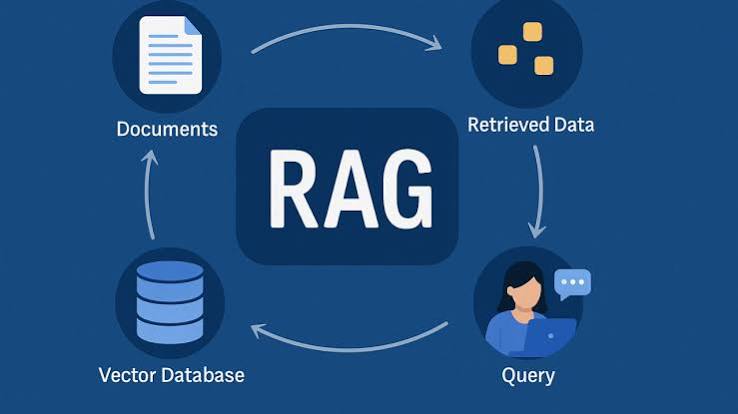
大模型知道很多,但不知道你公司的内部文档、上周的产品公告、你个人笔记里的那条备忘。直接问它,它要么坦白不知道,要么一本正经地编一个答案——后者就是臭名昭著的幻觉。RAG(Retrieval-Augmented Generation,检索增强生成)给出的解法是:回答之前先查资料——把相关的私有知识实时检索出来,塞进上下文,再让模型基于资料作答。这是当前企业级 AI 应用采用率最高的架构,没有之一。本…
Jina AI 详解:搜索基础设施工厂与它的 Reader 门面RAG 和 Agent 系统的痛点,一半在模型之外:网页抓不下来、PDF 解不出正文、搜索只给标题摘要——垃圾进、垃圾出。柏林公司 Jina AI 给出的答案是一整套"搜索基础设施":最广为人知的是 jina-ai/reader(约 12k Star,Apache 2.0)——任意 URL 加个前缀 https://r.jina.ai
GPT-Crawler:爬取网站一键生成你的专属 GPT想做一个"懂你们公司文档/产品"的 AI 助手?传统做法是手动把网页内容复制粘贴喂给 ChatGPT,但一个文档站动辄几百个页面,根本复制不过来。BuilderIO 的 gpt-crawler 正是为此而生——配置一个起始 URL 和 CSS 选择器,它就用 Playwright 无头浏览器自动爬取整站、提取每页正文、聚合成一个知识文件,上传
qmd 详解:Shopify CEO 开源的本地 Markdown 搜索引擎给 AI 代理喂"对的上下文"越来越重要,而多数方案要把笔记、文档传上云端。Shopify CEO Tobias Lütke(GitHub ID:tobi)开源的 qmd 给出了另一条路:一个完全跑在本地的迷你 CLI 搜索引擎,专门检索 Markdown 笔记、会议纪要与文档,把 BM25 全文检索、向量语义检索与 LL
GraphRAG 详解:微软基于知识图谱的 RAG 系统普通向量 RAG 擅长"找到相关段落",却答不好"这批文档整体讲了什么主题、各主题之间什么关系"这类全局性问题——因为答案散落在成百上千个chunk里,检索只能捞到零星几块。microsoft/graphrag(GraphRAG)就是微软为此提出的解法:先用 LLM 从文本里抽取实体与关系、构建知识图谱,再对图做社区聚类、逐层摘要,把"全局理
awesome-opensource-ai 详解:1024 个条目的开源 AI 全景图AI 开源生态这两年爆发式生长,缺的从来不是项目,而是一张靠得住的地图。alvinreal/awesome-opensource-ai(Awesome Open Source AI)就是这样一份清单:从 PyTorch、vLLM 到 LobeHub,从训练微调、推理服务到安全评测,横跨整个开源 AI 技术栈,单文
PandaWiki 详解:大模型时代的内容管理系统搭一个企业知识站,传统方案是 Wiki 系统 + 搜索引擎 + 人工维护,内容一多检索就失灵,更别提让访客"直接提问"。长亭科技开源的 chaitin/PandaWiki(PandaWiki)给出了另一种答案:一个由大模型驱动的开源知识库与 Wiki 系统,写好的内容自动向量化、自动可问答,访客既能像传统 Wiki 一样浏览,也能直接向 AI 提问
LlamaIndex 详解:构建 RAG 与代理应用的数据框架让大模型用上私有数据(文档、数据库、API),最成熟的路径就是 RAG;而把"接入数据、建索引、检索问答、编排代理"这套流程做成框架的,正是 run-llama/llama_index(LlamaIndex)。它是一个开源的数据框架,约 51.8k Star、MIT 协议,官方定位已从"LLM 应用的数据框架"演进到"构建代理应用(ag
WeKnora:腾讯开源的企业级知识库引擎企业里最痛的知识管理现状是:文档躺在飞书、Notion、语雀、本地 PDF 里"沉睡"——查不到、问不了、更不会自我生长。腾讯(微信团队)开源的 WeKnora 给出的答案是把它变成"活知识"(Living Knowledge):官方口号 "Turn Documents into Living Knowledge with RAG, Agents and
Code-Graph-RAG:用知识图谱重构代码 RAG理解一个陌生的大型代码库是开发者的日常痛点——接手几万行的项目,光搞清"这个函数被谁调用""数据怎么流转"就要花几天。传统代码 RAG 把代码当文本切片 + 向量检索,在跨文件的"调用关系""数据流"问题上力不从心,因为它不懂代码结构。Code-Graph-RAG(命令 cgr)换了个思路:用 Tree-sitter 把代码解析成 AST,把
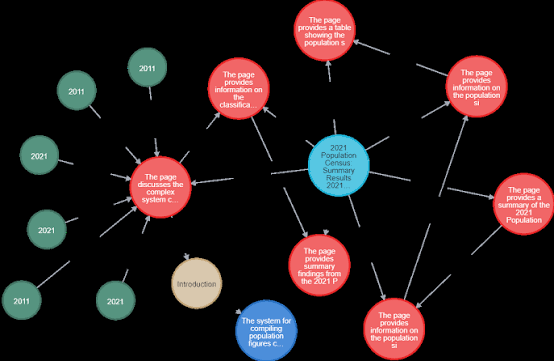
Docs2KG 详解:人机协同的异构文档知识图谱构建前面介绍了三个知识图谱工具——Graphify(代码库)、ai-knowledge-graph(纯文本)、Knowledge Graph Extractor(自托管)。它们各有侧重,但都有一个共同短板:LLM 自动提取完就结束了,没有人工审核和迭代闭环。提取错了怎么办?漏了实体怎么办?关系标错了怎么办?Docs2KG(AI4WA 团队,371 S
AI 知识图谱生成器详解:从非结构化文本到可视化图谱你有一堆文档(论文、报告、笔记、文章),想快速搞清其中的"谁和谁有关系、什么导致了什么、谁属于哪一类"——手动阅读提炼太慢,交给 LLM 又只给你一段总结文字。Robert McDermott 开源的 ai-knowledge-graph 恰好解决这个痛点:它用 LLM 从非结构化文本中自动提取"主-谓-宾"三元组(SPO triplets),然
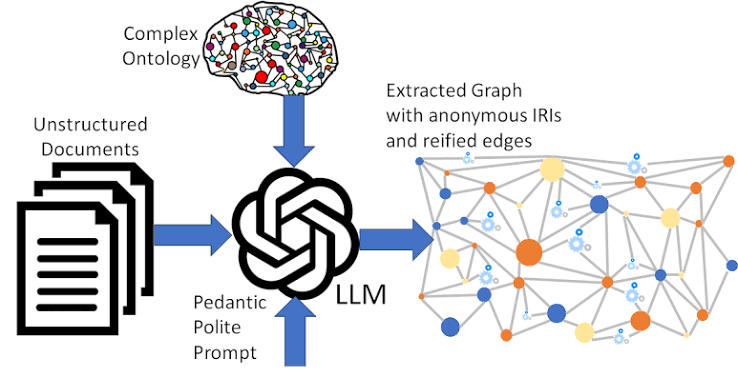
Knowledge Graph Extractor 详解:单卡自托管的知识图谱生成器前面介绍了 Graphify(代码库图谱)和 ai-knowledge-graph(文本图谱),它们都依赖外部 LLM API(Claude / GPT / Ollama)。但如果你想完全自托管——不调任何云 API、数据不出域、一张 GPU 就能跑——Knowledge Graph Extractor(Han X
Graphify 详解:把整个代码库变成可查询的知识图谱理解一个大型代码库有多痛苦?几万行代码、几十个模块、数百个文件,新人入职两周还在"这个函数在哪调用、这个模块依赖谁"里挣扎。Graphify(GitHub 近 95k Star,2026 年最火的开发者工具之一)就是来终结这个痛苦的——它把任何代码库(含文档、SQL、PDF、截图)自动转成一个可查询的知识图谱,每条关系都标注"确定的/推理的/