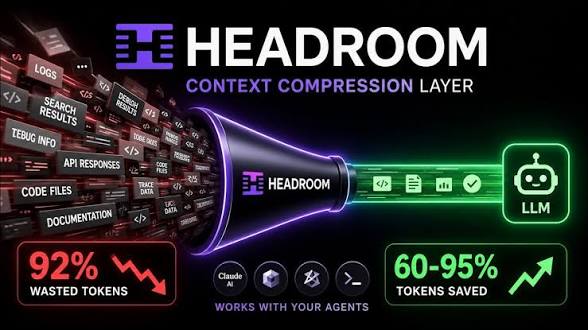
Headroom 详解:给 AI 代理的上下文压缩层
Headroom 详解:给 AI 代理的上下文压缩层AI 编码代理越能干,上下文就越容易爆炸:一次工具调用吐出几百行 JSON,一轮搜索带回整个代码库的日志,历史消息层层累积——这些都要按 token 付费,还拖慢推理。Headroom(Headroom Labs 出品,约 66.4k Star)把自己定位为"AI 代理的上下文压缩层":在工具输出、日志、文件、RAG 片段、对话历史到达大模型之前
113
分类
追踪大模型的实战前沿:模型横评与选型(Fable、GPT、Gemini、DeepSeek)、AI Agent 架构(浏览器代理、Computer Use、多智能体协作)、判断模型(Jev、Laya)、本地化部署(AnythingLLM、WebLLM)与开源 AI 生态全景。从原理拆解到落地配方,给出可复制的选型与工程结论。
共 162 篇文章
Headroom 详解:给 AI 代理的上下文压缩层AI 编码代理越能干,上下文就越容易爆炸:一次工具调用吐出几百行 JSON,一轮搜索带回整个代码库的日志,历史消息层层累积——这些都要按 token 付费,还拖慢推理。Headroom(Headroom Labs 出品,约 66.4k Star)把自己定位为"AI 代理的上下文压缩层":在工具输出、日志、文件、RAG 片段、对话历史到达大模型之前
GraphRAG 详解:微软基于知识图谱的 RAG 系统普通向量 RAG 擅长"找到相关段落",却答不好"这批文档整体讲了什么主题、各主题之间什么关系"这类全局性问题——因为答案散落在成百上千个chunk里,检索只能捞到零星几块。microsoft/graphrag(GraphRAG)就是微软为此提出的解法:先用 LLM 从文本里抽取实体与关系、构建知识图谱,再对图做社区聚类、逐层摘要,把"全局理
国产大模型 2026:DeepSeek、Kimi、Qwen 的现状与选型2026 年,国产大模型已经从"追赶者"变成"第一梯队常客"。DeepSeek 用开源推理震动业界,Kimi 把超长上下文做到极致,Qwen 搭起全尺寸多模态生态,智谱、豆包、MiniMax 各占一席。对国内团队而言,"用国产"已不再是退而求其次——在中文、成本、可控这三件事上,它往往是更优解。本文不止盘点,更讲清"怎么获取、
具身智能:当 AI 装进身体,从"会说"到"会做"大模型让 AI 学会了"说",可它依然被困在屏幕里——能滔滔不绝讲"如何拧螺丝",真给它一把螺丝刀却手足无措。要让它真正"动手",就得给它一个"身体"。具身智能(Embodied AI)研究的正是"有身体的 AI 如何在真实世界感知与行动"。2026 年人形机器人密集进厂、进家,具身智能正从论文走向现实。本文讲清它的范式演进、数据来源与核心挑战。1
别盲信大模型:幻觉的根源与分层校验方法论大模型越强大、回答越流畅,就越容易让人卸下戒备。但一项针对前沿 LLM 的实测给出一个扎心的数字:在约 67% 的真实世界事实验证上,不同模型给出的结论互相矛盾——同一个问题,Claude、GPT、Gemini 各执一词。详见 前沿 LLM 事实验证分歧。流畅,是 AI 最危险的伪装。本文不讲"幻觉很可怕"这种废话,而是讲透它为什么必然发生,以及如何用一套分
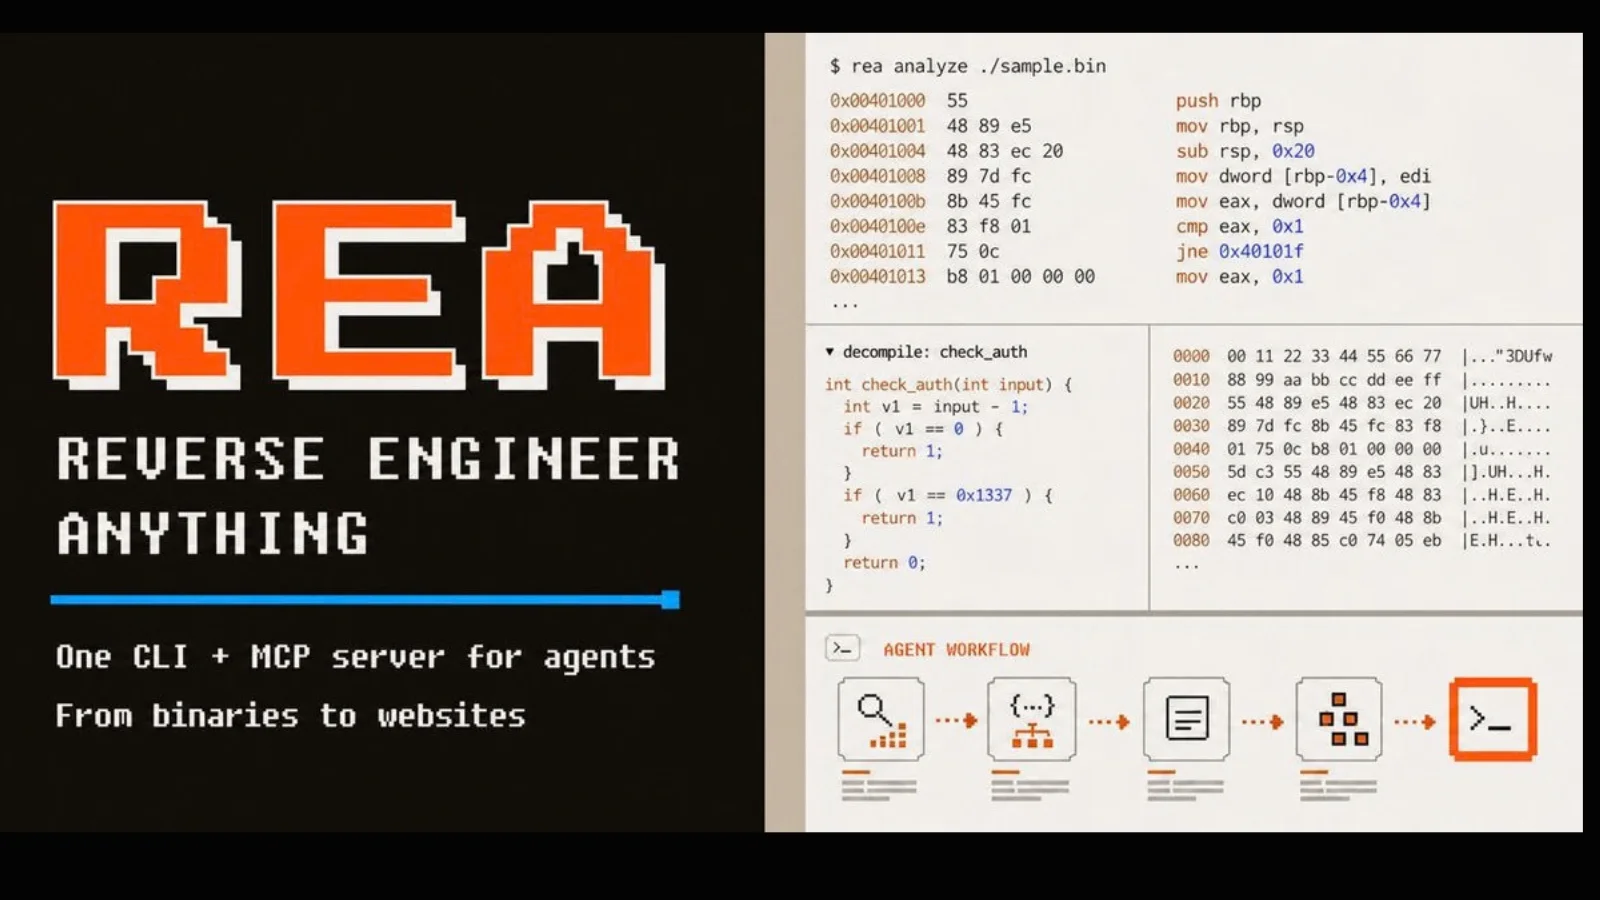
逆向工程一直是高度依赖专家经验的领域:打开 Hopper 看反汇编、翻字符串、追调用链——每一步都耗时且难以复用。REA(Reverse Engineer Anything)把这件事交给 Agent:一个 MCP 服务器加一套 Agent 技能,让 Claude Code、Codex、Cursor 等编码代理具备"从应用行为一路逆向到原生二进制"的能力——分析本地跑、证据随结论返回,Agent 拿…
世界模型:AI 的下一个前沿到底指什么LLM 学会了"语言",却有个致命盲区——它"懂词不懂世界"。它知道"摔碎"常和"杯子"一起出现,却未必真懂重力与碰撞;它能描述"向左打方向盘",却无法预测下一秒车的位置。要让 AI 走进物理世界、做长期规划,就得给它一个能"预演后果"的内部模拟器——这就是世界模型(World Model),被广泛视为继 LLM 之后 AI 的下一个前沿。延伸阅读。1、世界模
Codex 复兴:云端并行 Agent 与 CLI 双形态实战Codex 是 OpenAI 最早的代码模型名字,曾在 GitHub Copilot 初期立下汗马功劳,后被 GPT-4 系取代而沉寂。但 2025-2026 年,OpenAI 让它"重生"——不再是一个补全模型,而是一套云端 Agent + CLI的编程代理,被社区评为"令人意外地好用"。它的独门武器是云端并行:能同时在多个沙箱里跑多
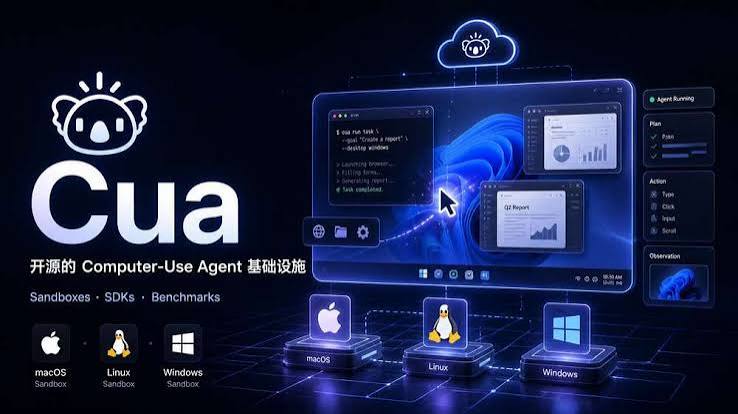
Cua 详解:给 AI Agent 一台能用的电脑Computer-Use Agent(CUA)的瓶颈往往不在模型,在机器:Agent 要操作真实桌面,就得有隔离的虚拟机、不抢鼠标的后台驱动、可复现的评测环境——这些基建各自都是脏活。trycua/cua(Cua,Computer-Use Agent 的缩写)把这层基建整体开源:Lume 管 Apple Silicon 上的 macOS/Linux
如果说深度学习这十年有什么基础设施级别的工程,Hugging Face 的 Transformers 一定排在前列。它把「下载一个预训练模型跑推理」从论文复现级别的难度,降到了一个 pipeline 调用的程度,文本、视觉、音频、多模态全都能吃。到今天 Hub 上的 Transformers 模型检查点已经超过 100 万个,几乎每个新发布的开源模型都会先给它提交架构支持。本文从项目定位讲起,覆盖…
Claude 能写代码、能聊天,但它默认不懂你们公司的销售流程、财务科目和法律条款——每个岗位的上下文都要从零教起。Anthropic 官方开源的 knowledge-work-plugins 就是来解决这件事的:一套面向知识工作者的插件库,把 Claude 变成特定岗位的专家,预装该领域的技能、命令、子代理与工具连接。仓库约 26.8k Star、Apache 2.0 协议。本文按"概述 → 插…
Laya 详解:可自托管微调的非自回归判断模型Jev 证明了"判断模型"这条路走得通,但它闭源、按 token 计费、只能云端调用。两天后(2026 年 9 月 18 日),NandhaKishorM 在 GitHub 开源了 NandhaKishorM/laya(Laya):多语言、非自回归的 System 1 判断引擎——三个 checkpoint(laya / laya-multilingu…
2026 大模型横评与选型:Fable 5、GPT-5.x、Gemini 3.x 怎么选 2026 年中,大语言模型早已不是"一家独大"。Anthropic、OpenAI、Google 三强贴身肉搏,国产 DeepSeek、Kimi、Qwen 紧咬不放,开源阵营持续走高。真正棘手的问题,已经不是"哪个模型最强",而是"我的场景该用哪个"——同一条任务,选错模型可能多花十倍成本、还更慢更差。本文先用…

Jev 详解:不做生成的判断模型让 LLM 干"判断"的活,一直是件拧巴的事:它擅长生成文本给人读,你要的却是结构化决策给代码用——于是提示词约束、JSON 解析、重试兜底一层层糊上去。TypeSafe AI 的答案是干脆换一类模型:Jev,首个 System One 模型——不做文本生成,专职快速、结构化的判断:输入状态与类型化问题,输出带概率与置信度的结构化答案,类型错误在数学上不可能发生,因
awesome-opensource-ai 详解:1024 个条目的开源 AI 全景图AI 开源生态这两年爆发式生长,缺的从来不是项目,而是一张靠得住的地图。alvinreal/awesome-opensource-ai(Awesome Open Source AI)就是这样一份清单:从 PyTorch、vLLM 到 LobeHub,从训练微调、推理服务到安全评测,横跨整个开源 AI 技术栈,单文